기준 정보: Co-Design Bench 논문(arXiv 2610.35138, 2026년 10월 26일 제출) · 과제 273개 · 모델 10개 · 2026년 11월 9일 논문 초록과 프로젝트 페이지에서 확인
AI에게 사이트나 앱을 고쳐 달라고 하면 대부분 "다 했어요"라고 답합니다. 그런데 실제 사용자 요청으로 AI 코딩 모델을 시험해 보니, 가장 좋은 모델도 요구 사항을 하나도 빠짐없이 채운 과제는 26.4% 였습니다. 이 글에서는 시험이 어떻게 진행됐는지, 그리고 바이브코딩을 할 때 "다 했어요"를 어떻게 확인하면 좋은지 세 가지로 정리합니다.
어떤 시험이었나요?
실제 사람들이 AI 코딩 도구에 보낸 수정 요청을 모아 만든 시험입니다. 연구진은 실제 사용자 코딩 세션 26,314개에서 중복을 뺀 요청 37,463개를 모았고, 이 가운데 과제 273개 를 골랐습니다. 과제마다 시작 앱이 실제로 빌드되고 실행되는지 확인한 뒤에 썼다고 밝혔습니다.
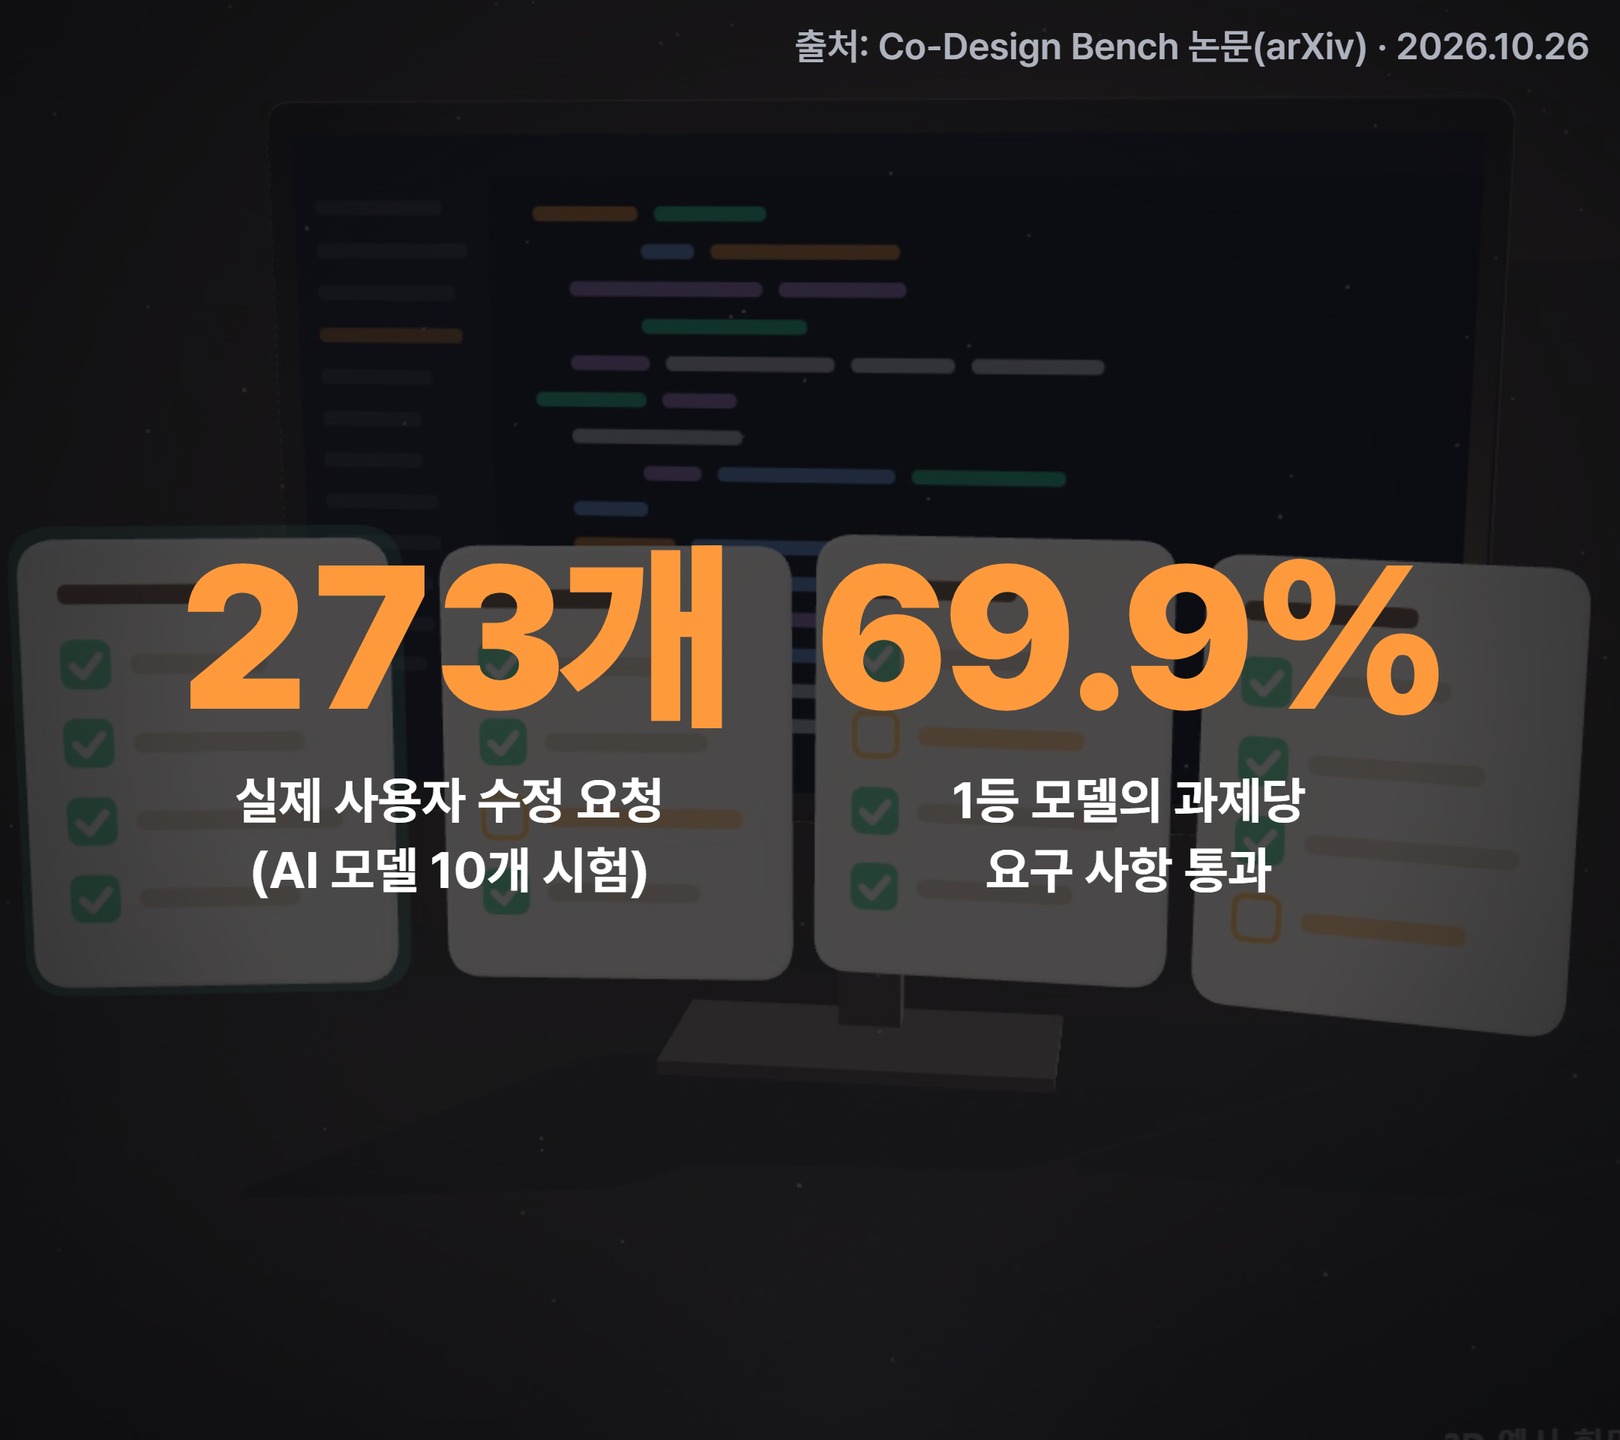
과제는 화면 이미지를 보고 고치는 과제 100개와 저장소(프로젝트 코드)를 고치는 과제 173개로 나뉩니다. 채점은 과제마다 숨겨 둔 확인 기준으로 하고, 기준은 모두 2,331개입니다. 같은 실행 환경에서 모델 10개를 돌렸습니다.
| 항목 | 값 |
|---|---|
| 과제 수 | 273개(화면 수정 100 · 저장소 수정 173) |
| 시험한 모델 | 10개 |
| 가장 좋은 모델의 완전 해결 | 26.4%(모든 기준 통과) |
| 가장 좋은 모델의 기준 통과 | 과제당 평균 69.9% |
왜 "다 했어요"를 그대로 믿으면 안 되나요?
거의 다 해 놓고 몇 군데를 빠뜨리는 경우가 많기 때문입니다. 가장 좋은 모델도 과제마다 확인 기준을 평균 69.9% 통과했지만, 전부 통과한 과제는 26.4%에 그쳤습니다. 평균으로 보면 기준 10개 중 7개쯤은 맞히지만, 하나도 빠뜨리지 않은 과제는 4개 중 1개꼴이라는 뜻입니다.
참고로 같은 연구진이 기존 시험(WebCompass-edit) 과제 150개로 비교했을 때는 점수가 훨씬 높게 나왔습니다. 한 모델은 한 번에 답하게 할 때 기능 완성도 73.6%에서, 에이전트 방식으로 돌리자 95.1%까지 올랐습니다. 쉬운 시험 점수가 높다고 실제 요청도 끝까지 해낸다는 뜻은 아니고, 같은 모델이라도 어떻게 돌리느냐에 따라 결과가 크게 달라진다는 점을 보여 줍니다. 모델 순위는 이 시험에 한정된 결과라 이 글에서는 다루지 않습니다.
어떤 요청에서 더 많이 빠뜨리나요?
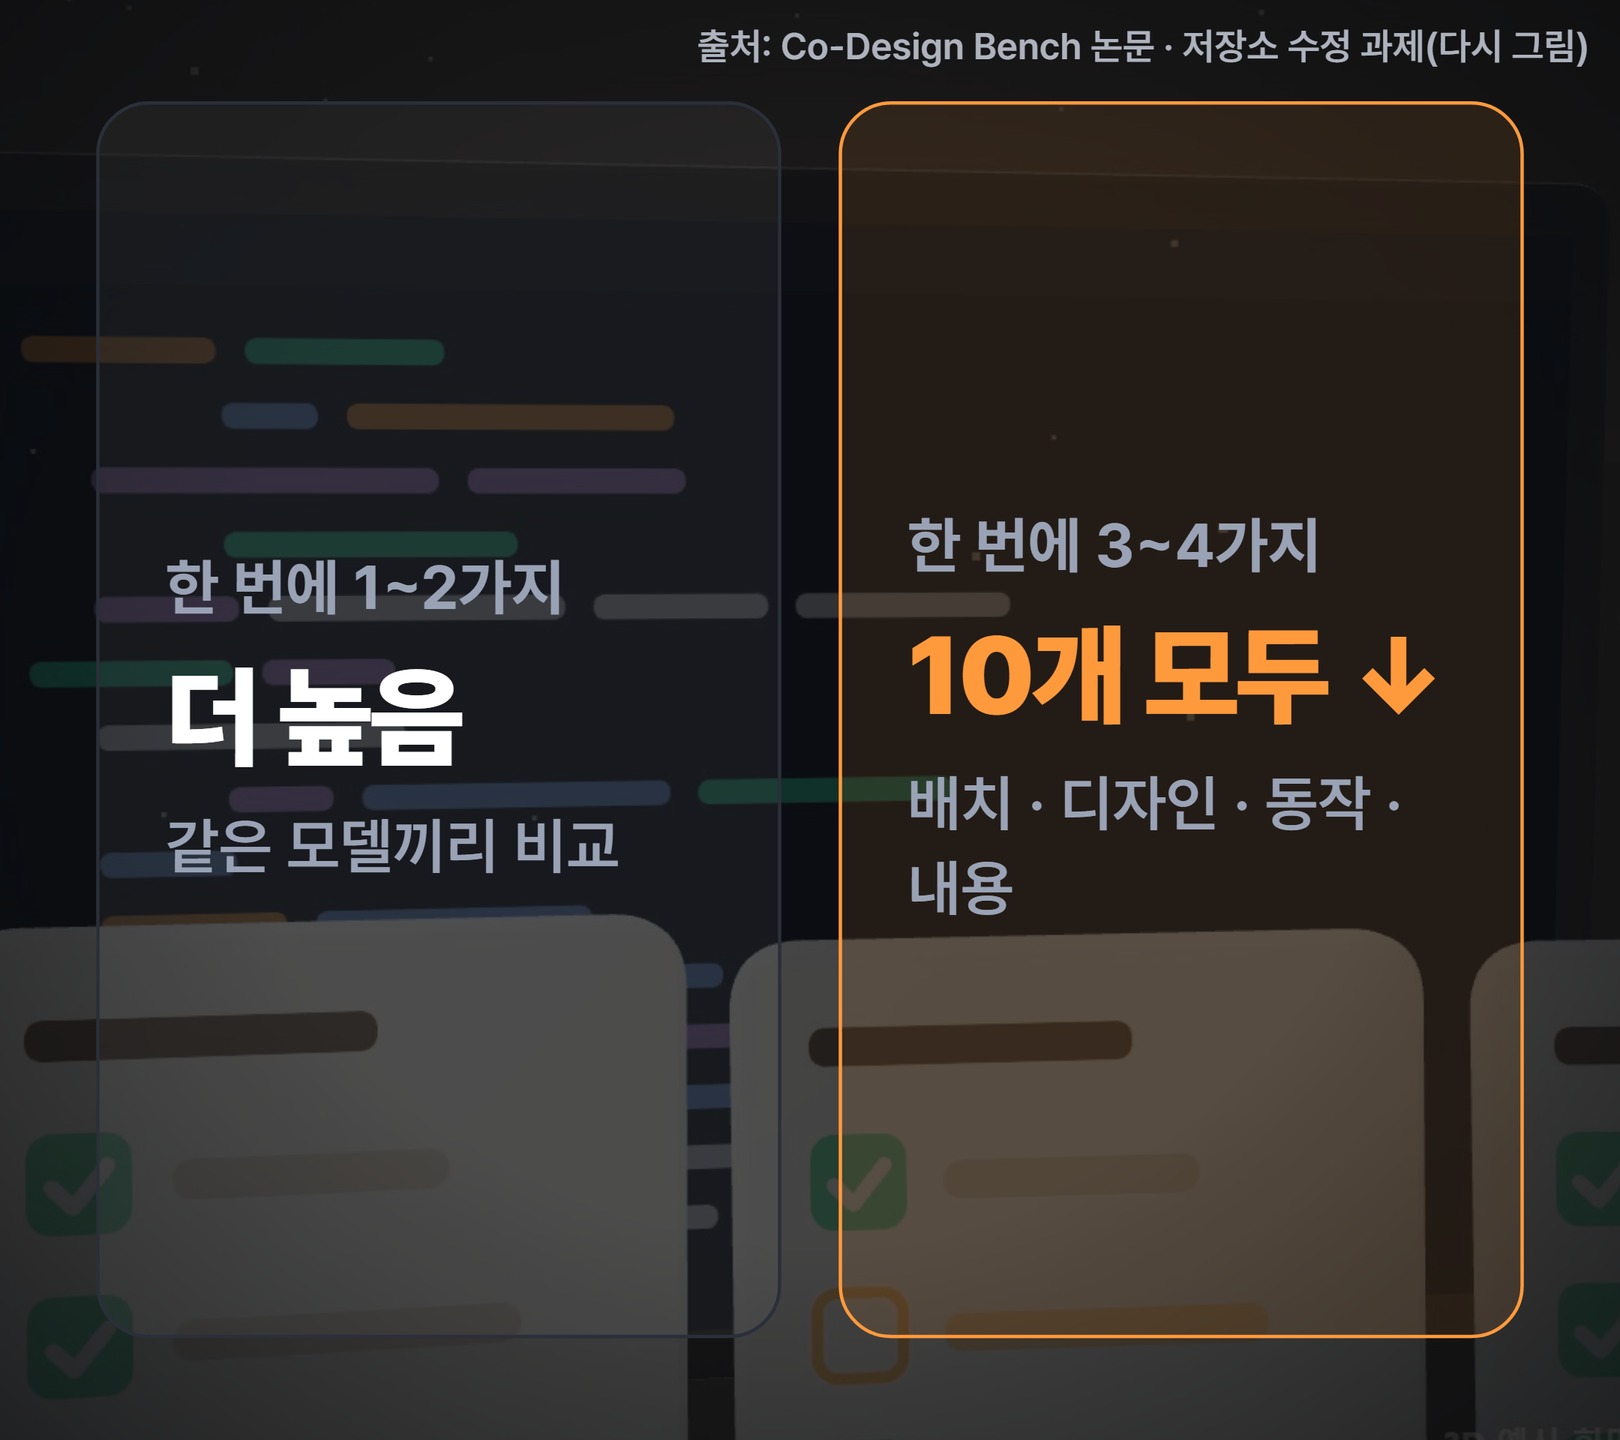
한 번에 여러 종류를 고치라는 요청입니다. 연구진은 저장소 수정 과제를 배치(구조) · 디자인(스타일) · 동작(상호작용) · 내용 네 종류로 나눴는데, 서너 종류를 한꺼번에 바꾸는 과제에서는 10개 모델 모두 한두 종류만 바꾸는 과제보다 기준 통과율이 낮았습니다. 173개 저장소 과제 가운데 166개가 두 종류 이상을 함께 바꾸는 과제였습니다.
그럼 어떻게 요청하고 확인하면 되나요?
요청을 쪼개고, 답을 번호로 받고, 마지막은 직접 눌러 봅니다. 순서대로 정리하면 이렇습니다.
- 한 번에 한 종류만 요청한다. 배치 → 디자인 → 동작 → 내용처럼 나눠서 보냅니다. "버튼 색 바꾸고, 장바구니 기능 넣고, 문구도 고쳐 줘"를 한 번에 보내지 않습니다.
- 요청에 번호를 달고, 번호별로 했는지 표로 답하게 한다. 빠진 번호가 표에서 바로 보입니다.
- 화면 크기 · 버튼 · 저장은 직접 눌러 본다. 창을 줄여 휴대폰 폭에서도 보고, 버튼을 하나씩 누르고, 저장한 뒤 새로 고침까지 해 봅니다.
번호 목록 요청은 실제로 어떻게 보이나요?
2026년 11월 9일, 예시로 만든 빵집 메뉴 페이지에 Claude Code로 디자인 요청 네 가지를 번호로 보내 봤습니다. 요청 끝에 "끝나면 번호별로 했는지 표로 답해."라고 붙였더니, 번호 · 요청 · 완료 여부 · 바꾼 내용을 표로 돌려줬습니다. 아래는 그 요청과 답의 일부입니다.
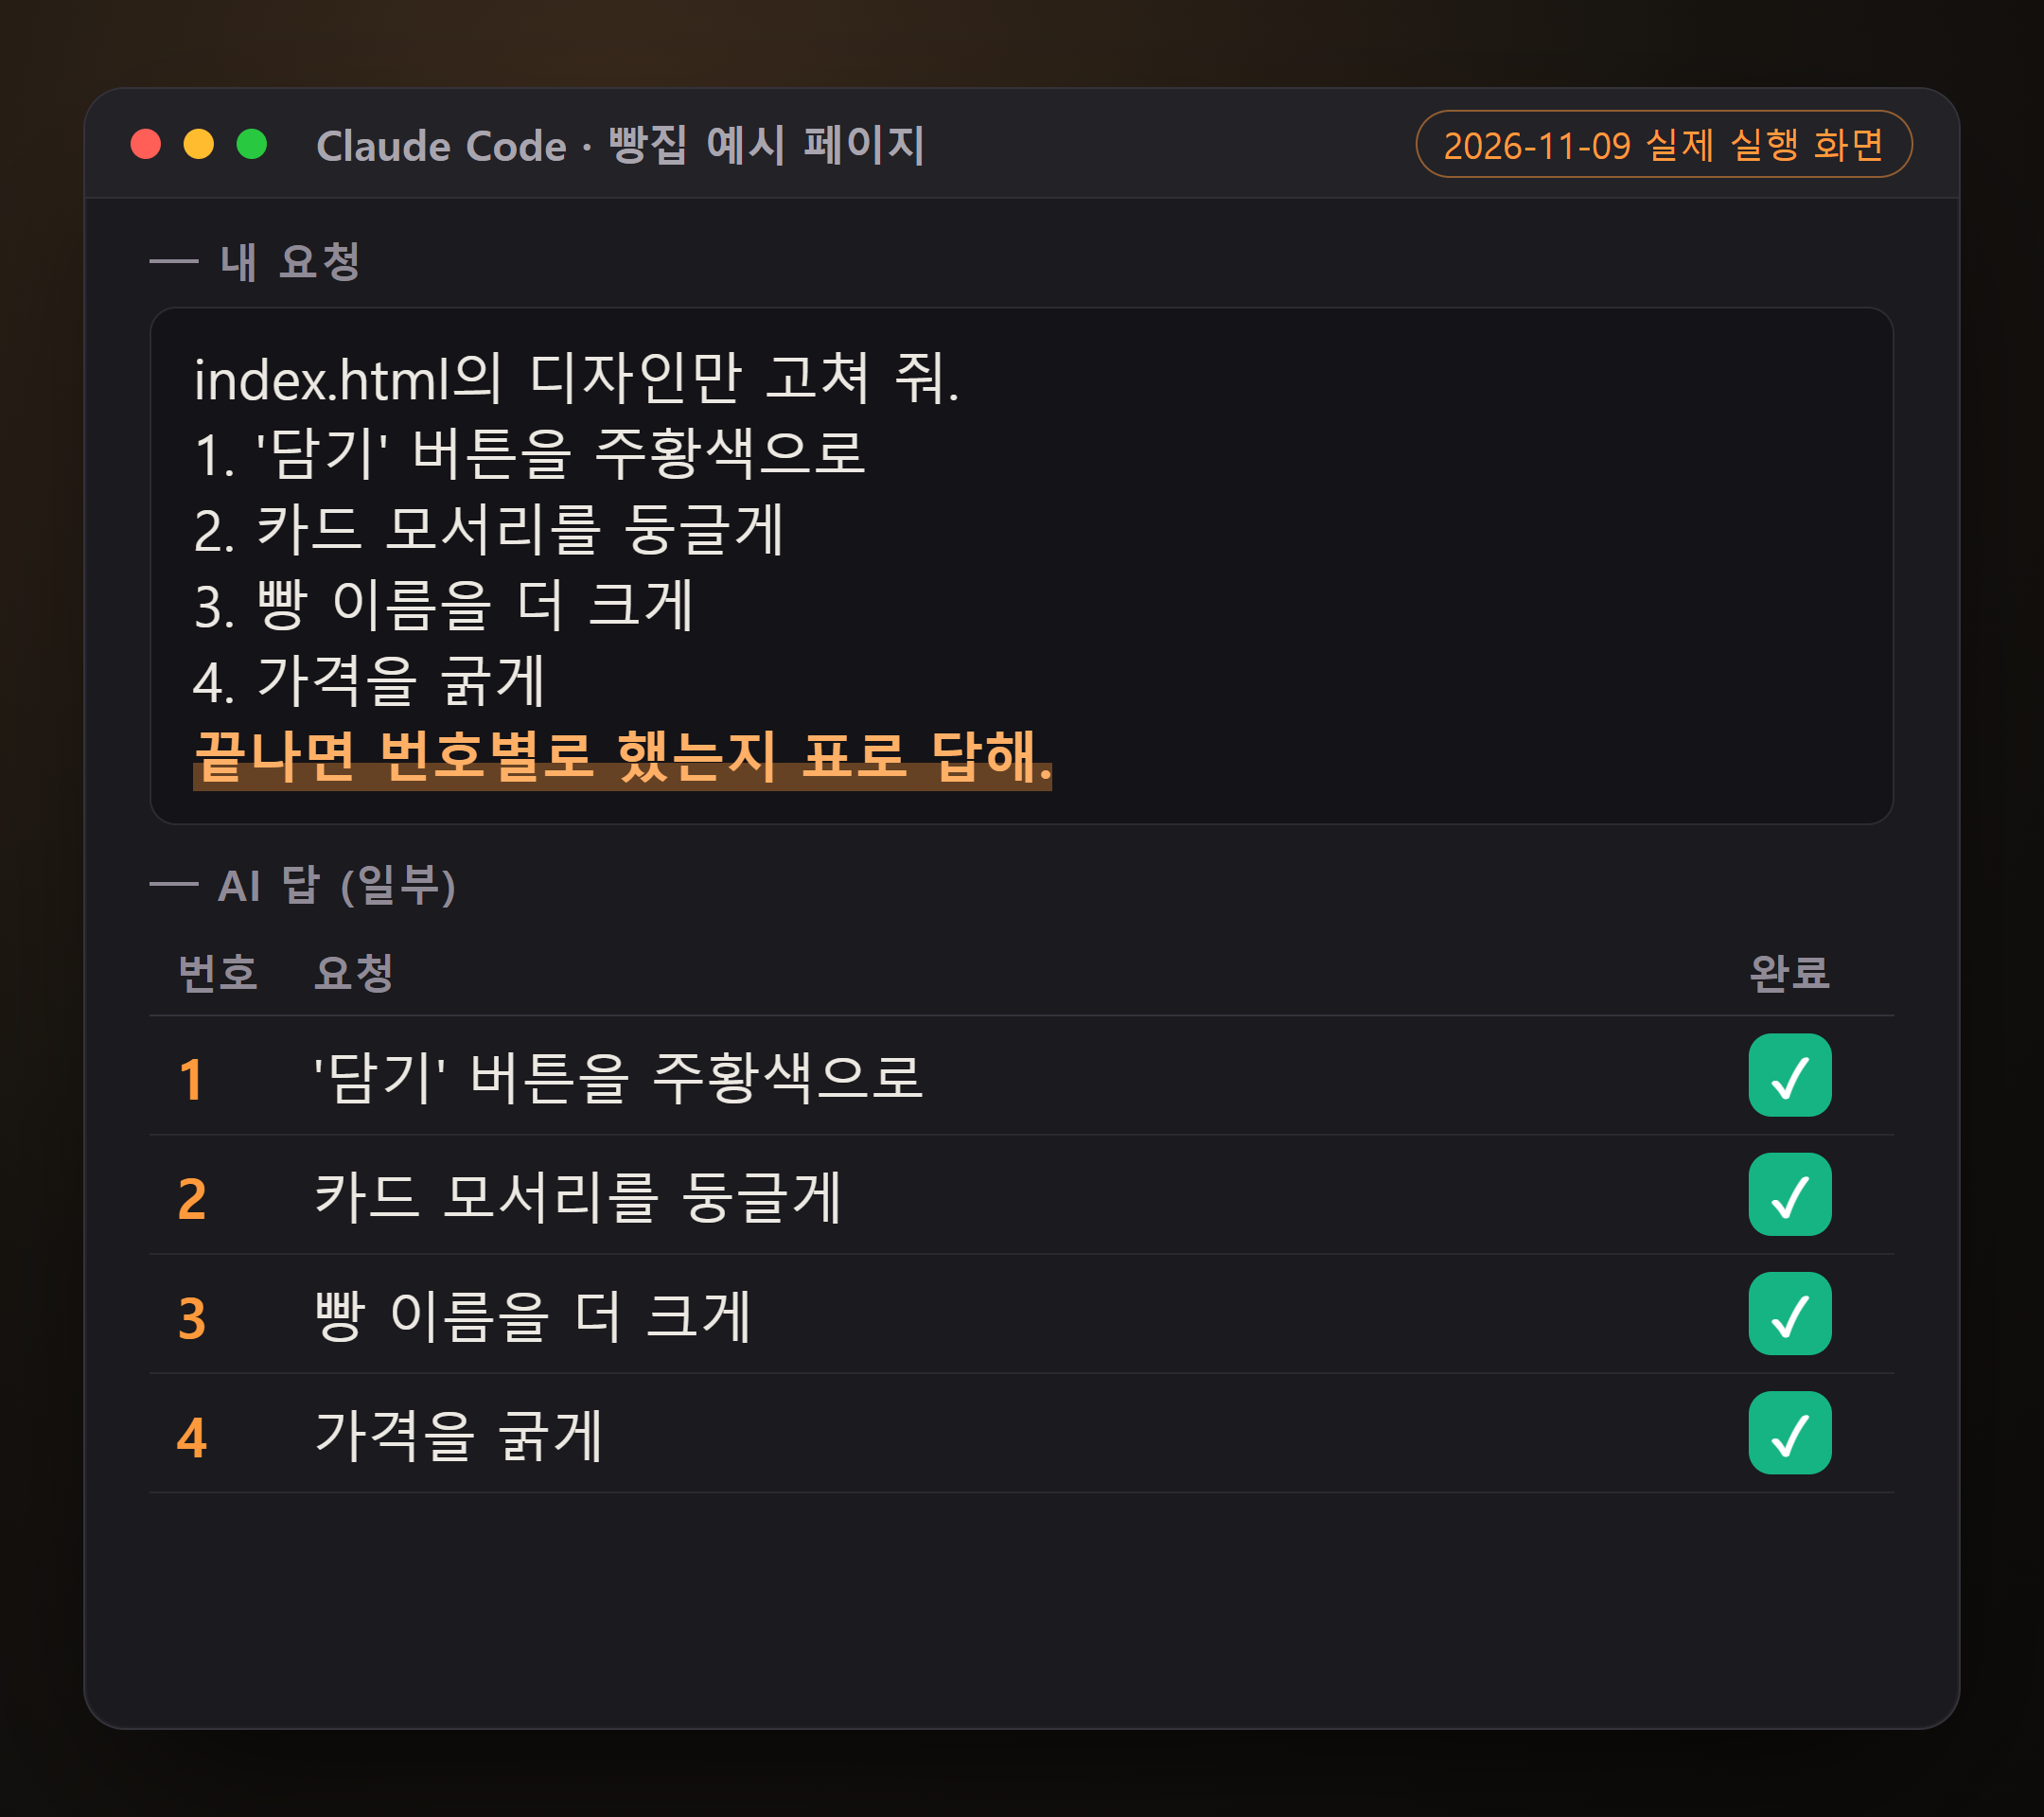
표에 "완료"라고 적혀 있어도 그대로 끝내지 않고, 화면에서 하나씩 맞춰 봤습니다. 아래는 고치기 전과 뒤의 실제 화면입니다. 버튼 색 · 둥근 모서리 · 큰 빵 이름 · 굵은 가격 네 가지가 모두 바뀐 것을 눈으로 확인할 수 있습니다.
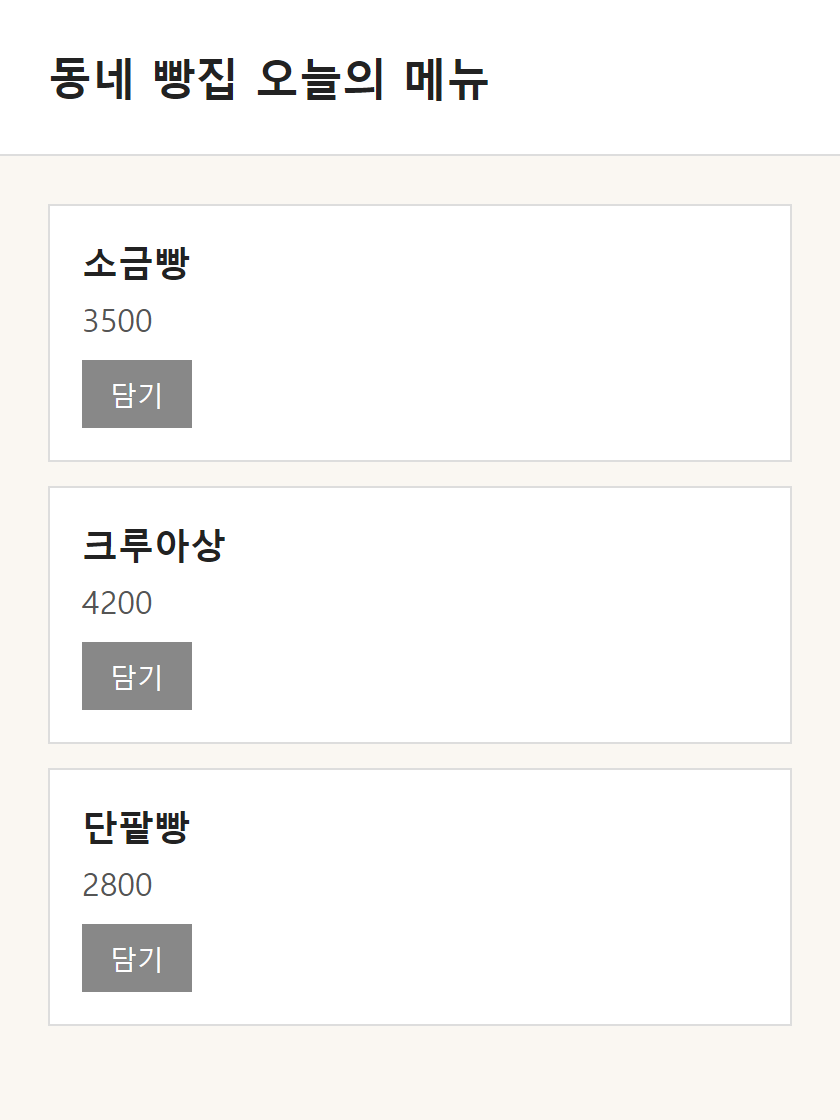
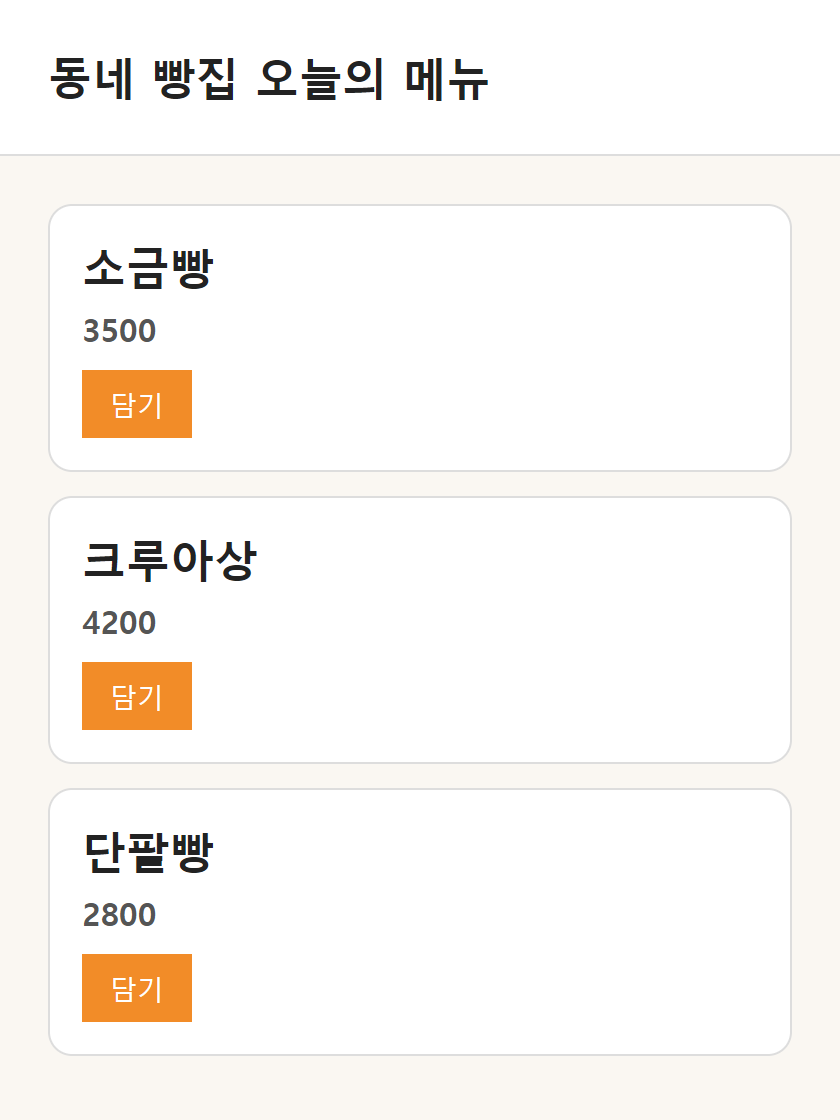
이 예시는 한 종류(디자인)만, 네 가지만 시킨 간단한 요청이라 모두 처리됐습니다. 요청이 길어지고 종류가 섞일수록 표에 빈칸이 생기기 쉬우니, 그때가 이 방법이 가장 쓸모 있는 때입니다.
직접 눌러 볼 때는 무엇을 보면 되나요?
AI가 코드만 보고 확인하기 어려운 부분부터 봅니다. 아래 세 가지는 화면을 직접 써 봐야 드러나는 경우가 많습니다.
- 화면 크기: 창을 줄였을 때 글자가 넘치거나 버튼이 겹치지 않는지
- 버튼: 새로 만든 버튼뿐 아니라 원래 있던 버튼도 그대로 동작하는지
- 저장: 저장한 뒤 새로 고침해도 내용이 남아 있는지
한 번에 정리
- 실제 요청 273개 시험에서 가장 좋은 모델도 완전히 끝낸 과제는 26.4%, 과제당 기준 통과는 평균 69.9%였습니다.
- 서너 종류를 한꺼번에 고치라는 요청에서는 10개 모델 모두 점수가 더 낮았습니다.
- 요청은 한 종류씩, 번호를 달아 보내고, 번호별 표로 답을 받고, 화면 크기 · 버튼 · 저장은 직접 눌러 확인합니다.
다음 편에서는 AI가 빼먹은 곳을 자동으로 잡아 주는 무료 도구를 소개합니다.
출처
- Co-Design Bench 논문(arXiv 2610.35138, 2026년 10월 26일 제출): https://arxiv.org/abs/2610.35138
- Co-Design Bench 프로젝트 페이지: https://codesignbench.github.io/
- 빵집 예시 페이지 요청 · 답 화면: AItoZ가 2026년 11월 9일 직접 실행
- 영상으로 보기: AItoZ 유튜브 쇼츠 'AI 코딩, 다 끝낸 건 26.4%'